OpenClaw使用感受
真正會做事的AI ?
這篇其實算是有感而發,我用OpenClaw差不多1個多月了,最直接的感受就是安裝終於變簡單了,但隨著架構越來越複雜,龍蝦的腦隨即也需要越來越好的模型來帶。
先說說我的配置,我的方式是Ubuntu中開一個VM專門給龍蝦用,VM的配置是
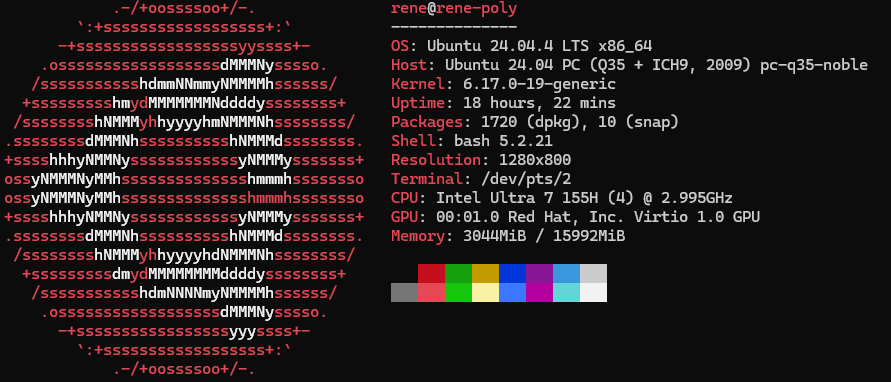
白話文就是VM配置為 4核心 16GB 256GB,目前龍蝦腦接的是OpenAI Codex GPT 5.4
我主要用來做什麼呢?
管理行程/Email這種事我是絕對用不到的,因為我沒有那麼多事情可以管(生活相對單純),email裡面也都是認證信, 垃圾信
我其實主要還是拿來做一些side project,驗證一些自己的想法看看能不能落地。用手機隨時監視進度跟下命令真是太爽了。
在模型上我走過的彎路,因為架構與上下文的關係,龍蝦很吃Token,大概每個人都沒想到這一點,高級Token真的是爆炸貴加上Gemini oAuth (AI Plus方案)被 google 封起來後真的是...跟龍蝦協作聊天比上酒店還貴。
Gemini oAuth這條路我就不說了(因為也用不了了,剛開始真的爽用)
自從這條路被封了之後,我開始使用OpenRouter API搭配Gemini Cli,剛開始的時候還好,我的用法大致上是OpenRouter選相對便宜一些的模型,做了幾個Gemini Cli Skill,讓Agent寫代碼的時候直接使用Gemini Cli,這樣緩解了一些token費用焦慮。
但是,用便宜模型(MinMax, Kimi, gemini flash, gpt-mini)當作大腦,隨即而來所帶來的問題就是, 因為模型本身考慮的不周到,當發出任務給Sub Agent時Sub Agent回報的成果很不穩定,整個行為變回了幾年前那種,AI為了完成任務敷衍了事的狀態,比如說我的流程通常是,SubAgent調用 Gemini Cli 做一個骨架(裡面都是mock)流程驗證通過後,然後再用Gemini Cli每一個mock去補實際邏輯,在高級模型的狀況下這套流程很完美(如Gemini 3 Pro,GPT 5.2-4),在便宜模型下則錯誤百出,為了驗證通過太常出現修修補補,邏輯跳過,維持Mock等等的問題,做的非常非常的敷衍,這跟以前AI會搞錯目的一樣(目的變成跑通流程而非把程式做好),讓我debug的非常非常非常之痛苦(因為這跟以前用IDE協作不一樣,用龍蝦這種黑箱你幾乎只能相信他)即便是便宜模型Token的費用也沒有比較少,反而變成Token錢花了時間花了,但沒有達成想要的結果。
最後我解決的方式是,一律使用高級模型,我現在的處理方式是,直接訂閱Chat GPT商業方案,兩個帳號版本。Codex額度是分開算的而且比Plus多。
目前運作算是良好。所以奉勸用龍蝦的人,請不要覺得高級頂級模型可惜,他真的可以幫你省下很多很多的時間與費用。
Agent 系統的成本 其實不是 單次推理成本,如果混在一起看你就糟了,這才是真正的成本算法
總成本 =(模型品質 × 任務成功率)+(錯誤修復成本 × 迭代次數)